如何在 AgentCore 与 OpenClaw 上构建上下文感知的 AI 助手
Building a context-aware AI assistant on AgentCore and OpenClaw
开源智能体系统 OpenClaw 运行在 Amazon Bedrock AgentCore 的 runtime 上,用来把每次从零开始的助手做成会积累个人上下文的助手。
现成的 AI 助手能很好地回答单个问题,但在另一个维度上有所不足:连续性。今天向一个无状态助手询问你的花园,它并不知道你三周前提到过排水很快的高架种植床、你只用有机肥料,或者你的矮牵牛曾在热浪中挣扎。每次对话都从零开始,重新解释上下文的负担落在用户身上。
问题不在于回答的质量,而在于助手对你没有记忆。本文展示如何使用 OpenClaw(一个开源智能体系统)构建一个会积累上下文的个人助手,它运行在 AgentCore runtime(Amazon Bedrock AgentCore 的一项能力)上。AgentCore memory(Amazon Bedrock AgentCore 的一项能力)将一次性聊天转化为持久知识。你还将看到如何用结构化元数据为这些记忆打标签,以便检索与当前问题相关的记录。
我们贯穿全文的示例是 Sprout,一个园艺助手,但该架构与领域无关。换掉人设和技能清单,同一条流水线就能服务于支持机器人、健身教练或内部服务台。整个系统位于单个 AWS CloudFormation 模板中,一条命令即可部署,并按用量计费运行,轻度个人使用每月只需几美元。在此过程中,我们会分享可应用于你在此技术栈上构建的助手的设计准则。
解决方案概述
AgentCore 是一个用于大规模构建、连接和优化智能体的平台,支持任意框架或模型。下图展示了端到端请求流:从入站 Telegram webhook 经过 AgentCore runtime,以及为其提供支持的 AWS 服务。

图 1:Telegram webhook 与 Amazon EventBridge 计划都会调用同一个 AgentCore runtime 智能体,由它协调 OpenClaw gateway、AgentCore memory 和 Amazon Bedrock
两个入口汇聚到同一个智能体。Telegram 消息经由 Amazon API Gateway 和一个 webhook AWS Lambda 函数到达,而诸如早晨浇水提醒之类的计划任务则经由 Amazon EventBridge Scheduler 和一个 cronjob Lambda 函数到达。两者都会调用 AgentCore runtime 上的 InvokeAgentRuntime API,其中一个精简的 server.py 进程负责协调 OpenClaw gateway、AgentCore memory 以及 Amazon Bedrock Converse API。Amazon Simple Storage Service (Amazon S3) 提供工作区存储,AWS Key Management Service (AWS KMS) 负责加密,AWS Secrets Manager 保存机器人令牌,Amazon CloudWatch 采集日志和指标。
先决条件
要使用 Launch Stack 按钮或 scripts/deploy.sh(在 Grow your own 一节中说明)部署你自己的版本,你需要:
- Amazon Bedrock AgentCore 访问权限,包括 AgentCore runtime 和 AgentCore memory。
- 已为你计划路由到的模型授予模型访问权限:文本使用 Claude Haiku 4.5,视觉使用 Claude Sonnet 4.5(或你账户中可用的同等模型)。
- 支持
linux/arm64构建的 Docker,以及已配置的 AWS Command Line Interface (AWS CLI)。仅当你打算构建并推送自己的镜像时才需要。 - 一个 Telegram 机器人令牌(来自 BotFather),用作助手的前门。
- 对智能体编排概念和 CloudFormation 的基本了解。
架构:AgentCore runtime 上的无服务器智能体
每个组件都位于单个 CloudFormation 模板中,启动时无需任何构建工具。以下各节将逐一讲解那些承重的决策。
AgentCore runtime:只为活跃计算付费
智能体运行在 AgentCore runtime 上的容器中,采用按用量计费。你只需为智能体实际消耗的计算付费,而不是按墙上时钟的运行时间计费,等待 I/O(例如模型响应)的时间也不计费。对于短时突发使用的个人助手,这就是大约 $1–2/month 的基线成本与大约 $35/month 的常开 Amazon Elastic Compute Cloud (Amazon EC2) 实例之间的差别。这些数字是截至 July 2026 针对轻度个人使用的估算。当前费率请参阅 AgentCore 定价。
运行时强制执行最小容器约定:监听端口 8080,并暴露 GET /ping 用于健康检查、POST /invocations 作为智能体入口。我们的容器是 linux/arm64,基于官方 OpenClaw 镜像加上 Python 层进行多阶段构建。
OpenClaw 作为智能体底层
OpenClaw 提供智能体循环、工具使用和技能系统。它运行一个包装器(server.py),将其适配到 AgentCore HTTP 协议约定:
- 容器启动时,
server.py以子进程方式启动openclaw gateway run并对其进行健康检查。 GET /ping会迅速返回健康状态,因此 AgentCore 就绪探针能够通过。POST /invocations承担实际工作:解析载荷、检索记忆、组装上下文、将本轮对话转发到网关,并持久化结果。需要特别说明的一点:AgentCore 可以解冻一个子进程已退出的冻结容器。因此调用路径不会假定网关仍在运行,它会调用ensure_openclaw_ready()辅助程序,在转发本轮对话之前重新检查健康状态(并在需要时重启网关)。
这种包装器模式可以推广到其他用例。任何以本地进程方式运行的智能体框架都可以用同样的方式适配到 AgentCore runtime,而无需修改框架本身。
两个模型,按任务路由
文本聊天和图像理解在成本与质量上的权衡不同,因此助手将它们路由到 Bedrock 上的不同 Claude 模型:
- 文本使用 Claude Haiku 4.5:对于日常使用中占主导的大量对话轮次,它又快又便宜。
- 视觉使用 Claude Sonnet 4.5:针对根据照片诊断植物这一频率较低但更难的任务,提供更强的多模态推理能力。
文本轮次流经 OpenClaw 网关,从而带上技能和会话状态。图像轮次从 server.py 直接调用 Bedrock 上的大语言模型(LLM),将图像字节作为多模态内容块传入。我们有意让图像绕过网关:容器内的 OpenClaw 构建在内容到达 Bedrock 之前丢弃了 image_url 内容部分,因此从 server.py 直接调用 Converse API 可以确保模型看到实际像素。两条路径共享同一系统提示(人设加记忆),因此体验保持一致。
模型 ID 是环境变量(MODEL_ID、VISION_MODEL_ID),因此你可以按部署更换模型,而无需重新构建镜像。
技能作为可复用的能力单元
能力在 community-skills.json 清单中声明为技能。部署时脚本会在镜像构建之前将它们具体化到容器中,并注册到 OpenClaw 配置里。在本文发布时,Sprout 附带天气、提醒和植物笔记技能。更换清单后,同一条流水线即可服务不同领域。这使整套方案成为一种可复用模式,而不仅仅是一个机器人。
Telegram 作为无服务器前门
Telegram 是个人助手的实用渠道,因为它基于 webhook,并且能让一切保持无服务器。它无需客户端开发,可在用户已有的每台设备上运行,并通过简单的 bot API 支持文本、图片和富文本格式。BotFather 会签发一个 bot token,该 token 存储在 Secrets Manager 中。部署会注册一个 webhook,将 Telegram 指向 API gateway 端点。当用户发送消息时,Telegram 会将其投递到 webhook Lambda 函数,以校验载荷并调用 InvokeAgentRuntime。回复再通过 telegram bot API 返回。
有一条格式方面的经验值得注意:Telegram 的旧版 markdown 模型对未转义字符毫不宽容,模型回复中哪怕出现一个多余的下划线,都可能让整条消息发送失败。将回复渲染为 HTML 是可靠的,因此助手会在发送前把模型输出转换为对 Telegram 安全的 HTML。
记忆:把一次性聊天变成持久知识
到目前为止描述的架构是一个能力强、成本低的无服务器智能体,但它本身仍会在各次对话之间忘记你。记忆改变了这一点。想象一下,几周前你提到自己以有机方式园艺,而今天助手推荐一种处理方法,并自行补充说,它选择了有机方案,因为你不使用合成肥料。无状态模型做不到这一点。
心智模型:短期事件,长期抽取
AgentCore memory 有两层。短期记忆通过 CreateEvent 将每一轮对话存储为一个事件,以 actorId(Telegram 聊天 ID)和 sessionId 作为键。这是原始记录。长期记忆是异步生成的,由托管抽取策略转化为持久的结构化记录。我们配置了三种策略:
USER_PREFERENCE:园丁明确陈述的选择(“我只用有机肥料”)。SEMANTIC:推断出的事实(“在 Corten 钢高架花坛中种植墨西哥矮牵牛”)。SUMMARIZATION:情节性会话摘要(“在热浪期间讨论了下部叶片变黄的问题”)。
命名空间:每位园丁一座花园
Sprout 将记录归档到按用户划分的命名空间中,因此任意两次聊天都不会混在一起:
sprout/{chat_id}/long_term:偏好与语义事实。sprout/{chat_id}/episodic/{session_id}:会话摘要。
聊天 ID 是唯一的可变段,这使得隔离既易于理解也易于测试:每位独特的园丁恰好映射到一个命名空间,且任意两位园丁都不会冲突。
检索、组装与注入流水线
在每一轮中,智能体会检索相关的长期记录,对它们排序,并注入到系统提示中。以下是每条消息在 server.py 内部发生的事情:
- 检索。以用户消息作为搜索查询,针对
sprout/{chat_id}/long_term调用RetrieveMemoryRecords,结果上限为 50 条,预算为 3 秒。如果检索超时或出错,我们会优雅降级,在没有记忆的情况下作答,而不是直接失败。
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
代码片段 1:检索当前轮次的长期记录(代表性示例。完整源码请参见代码仓库)。
Assemble 函数会加入额外的自定义逻辑。我们希望显式偏好排在推断事实之前,每一类内部的顺序保持稳定,并且在注入前对结果进行上限截断:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
代码片段 2:组装步骤将显式偏好排在推断事实之前。
元数据:在命名空间内对记忆进行子分组
命名空间回答一条记录属于谁的记忆,而元数据回答它关于什么。在 sprout/{chat_id}/long_term 内部,对“我的矮牵牛正在枯萎”进行语义搜索,会返回所有含义相近的内容。对园丁来说,这意味着三月的施肥偏好和一则无花果树修剪笔记会与真正重要的记录并列排序。而结构化元数据有助于在记忆到达提示词之前缩小其范围。
这里的每一项决策都由一条规则决定。只有将元数据键声明为索引键,才能在服务端对其进行过滤。你可以在 Amazon Bedrock AgentCore Memory 中使用元数据进行结构化记忆过滤 中阅读更多内容。在本例中,sprout 使用三个索引键:
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
每个条目都会指定一个键,该键必须与某个索引键匹配才能被过滤,并将 extractionType 设置为 STRICTLY_CONSISTENT(从事件透传)或 LLM_INFERRED(从对话中提取)。对于推断键,提取配置可以将取值限制为固定列表。Sprout 正是这样做的,因此两条写入路径会创建相同的词汇表,无论记录由哪一部分创建,过滤器的含义都相同。
持久化本轮对话并闭合循环
模型响应后,server.py 会同时携带用户轮次和助手轮次调用 CreateEvent。这个新事件会输入提取策略,从而为下一次丰富长期存储。
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
代码片段 3:持久化本轮对话,以便提取策略能够异步丰富长期记忆。
提取是异步的,因此本会话中提到的事实通常要到后续会话才能被检索到。请针对这一延迟进行设计:短期会话事件覆盖当前对话,长期记录覆盖此前的一切。
整合起来:个性化浇水计划
完整流水线在这里端到端地运转。经过几次对话,你用通俗语言逐株记录整个花园。每一次提及都会成为一个事件。提取策略会把植物、其所在位置以及日照情况的信息提取到 sprout/{chat_id}/long_term 中。今天早上用户问了一个问题:“你还记得我花园里的其他植物吗?”检索把记录拉回来,组装过程对它们排序,然后它们进入系统提示词。助手的回答包含用户的位置、日照、苗床构造、土壤特性以及植物清单,而这些都没有出现在消息本身中。
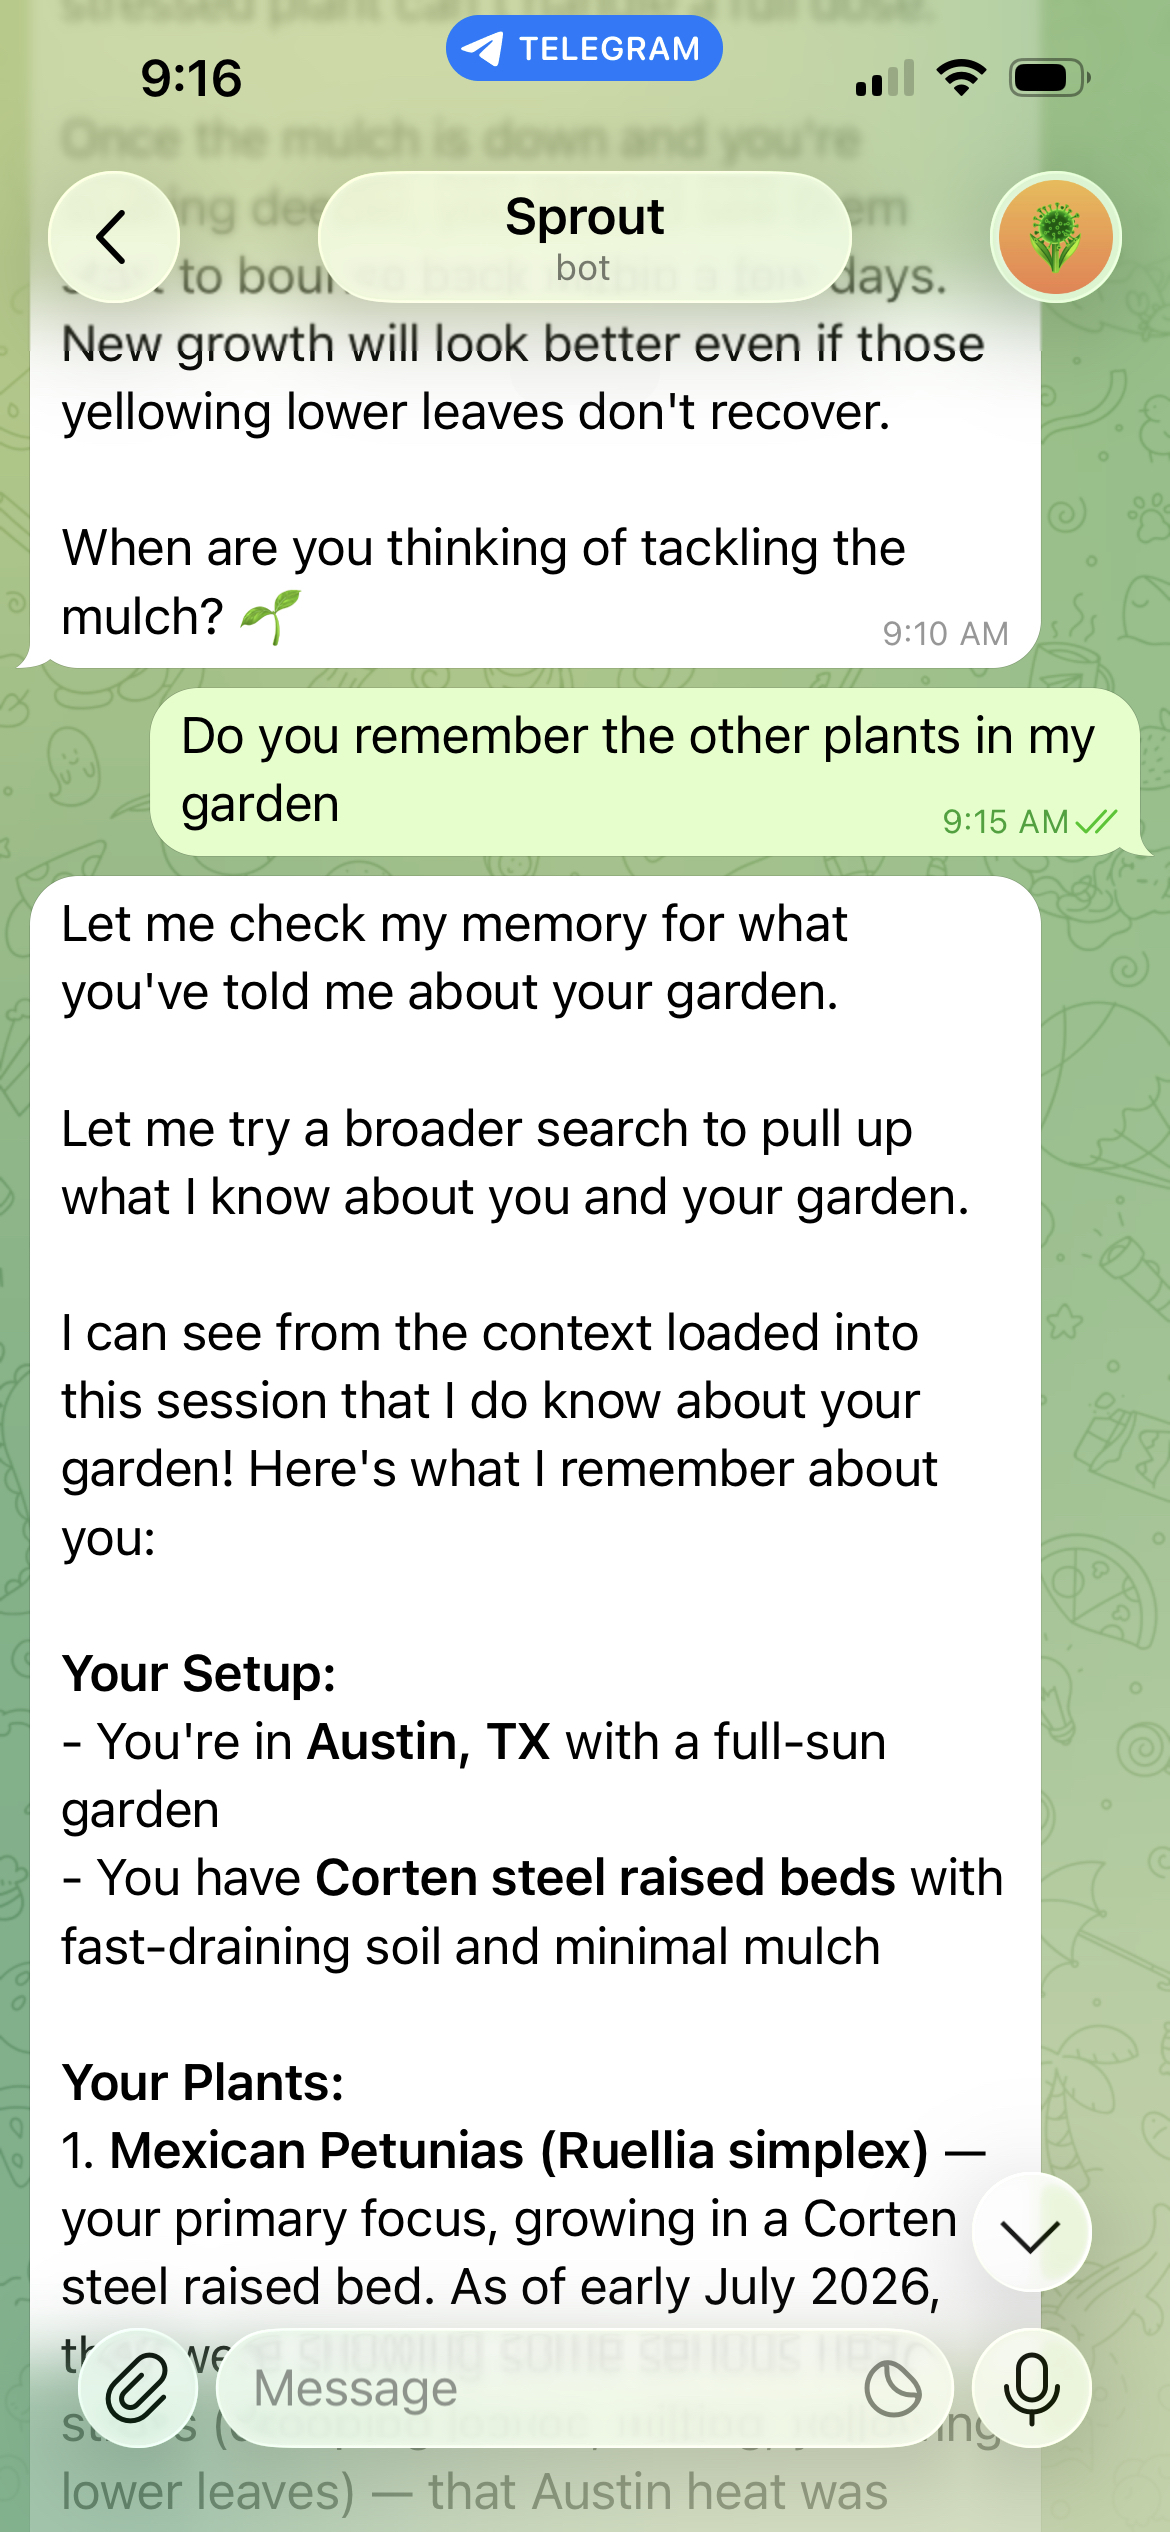
图 2:Sprout 通过回忆已存储的植物清单和生长条件来回答关于花园的问题
借助 Amazon EventBridge → Cron 路径上的调度器技能,Sprout 还可以把该计划变成主动提醒(“先别浇香草,土壤从昨天起还是湿的”),并在即将下雨或热浪来临时根据天气技能进行调整。
记忆与视觉也会相互增强。当用户发送一张枯萎植物的照片时,图像会送到 Claude Sonnet 4.5,同时系统提示词仍携带记忆层所知的一切。助手会把照片与用户已保存清单中的墨西哥矮牵牛匹配起来,并在上下文中诊断萎蔫胁迫,而不是对一张匿名植物照片做冷分析。
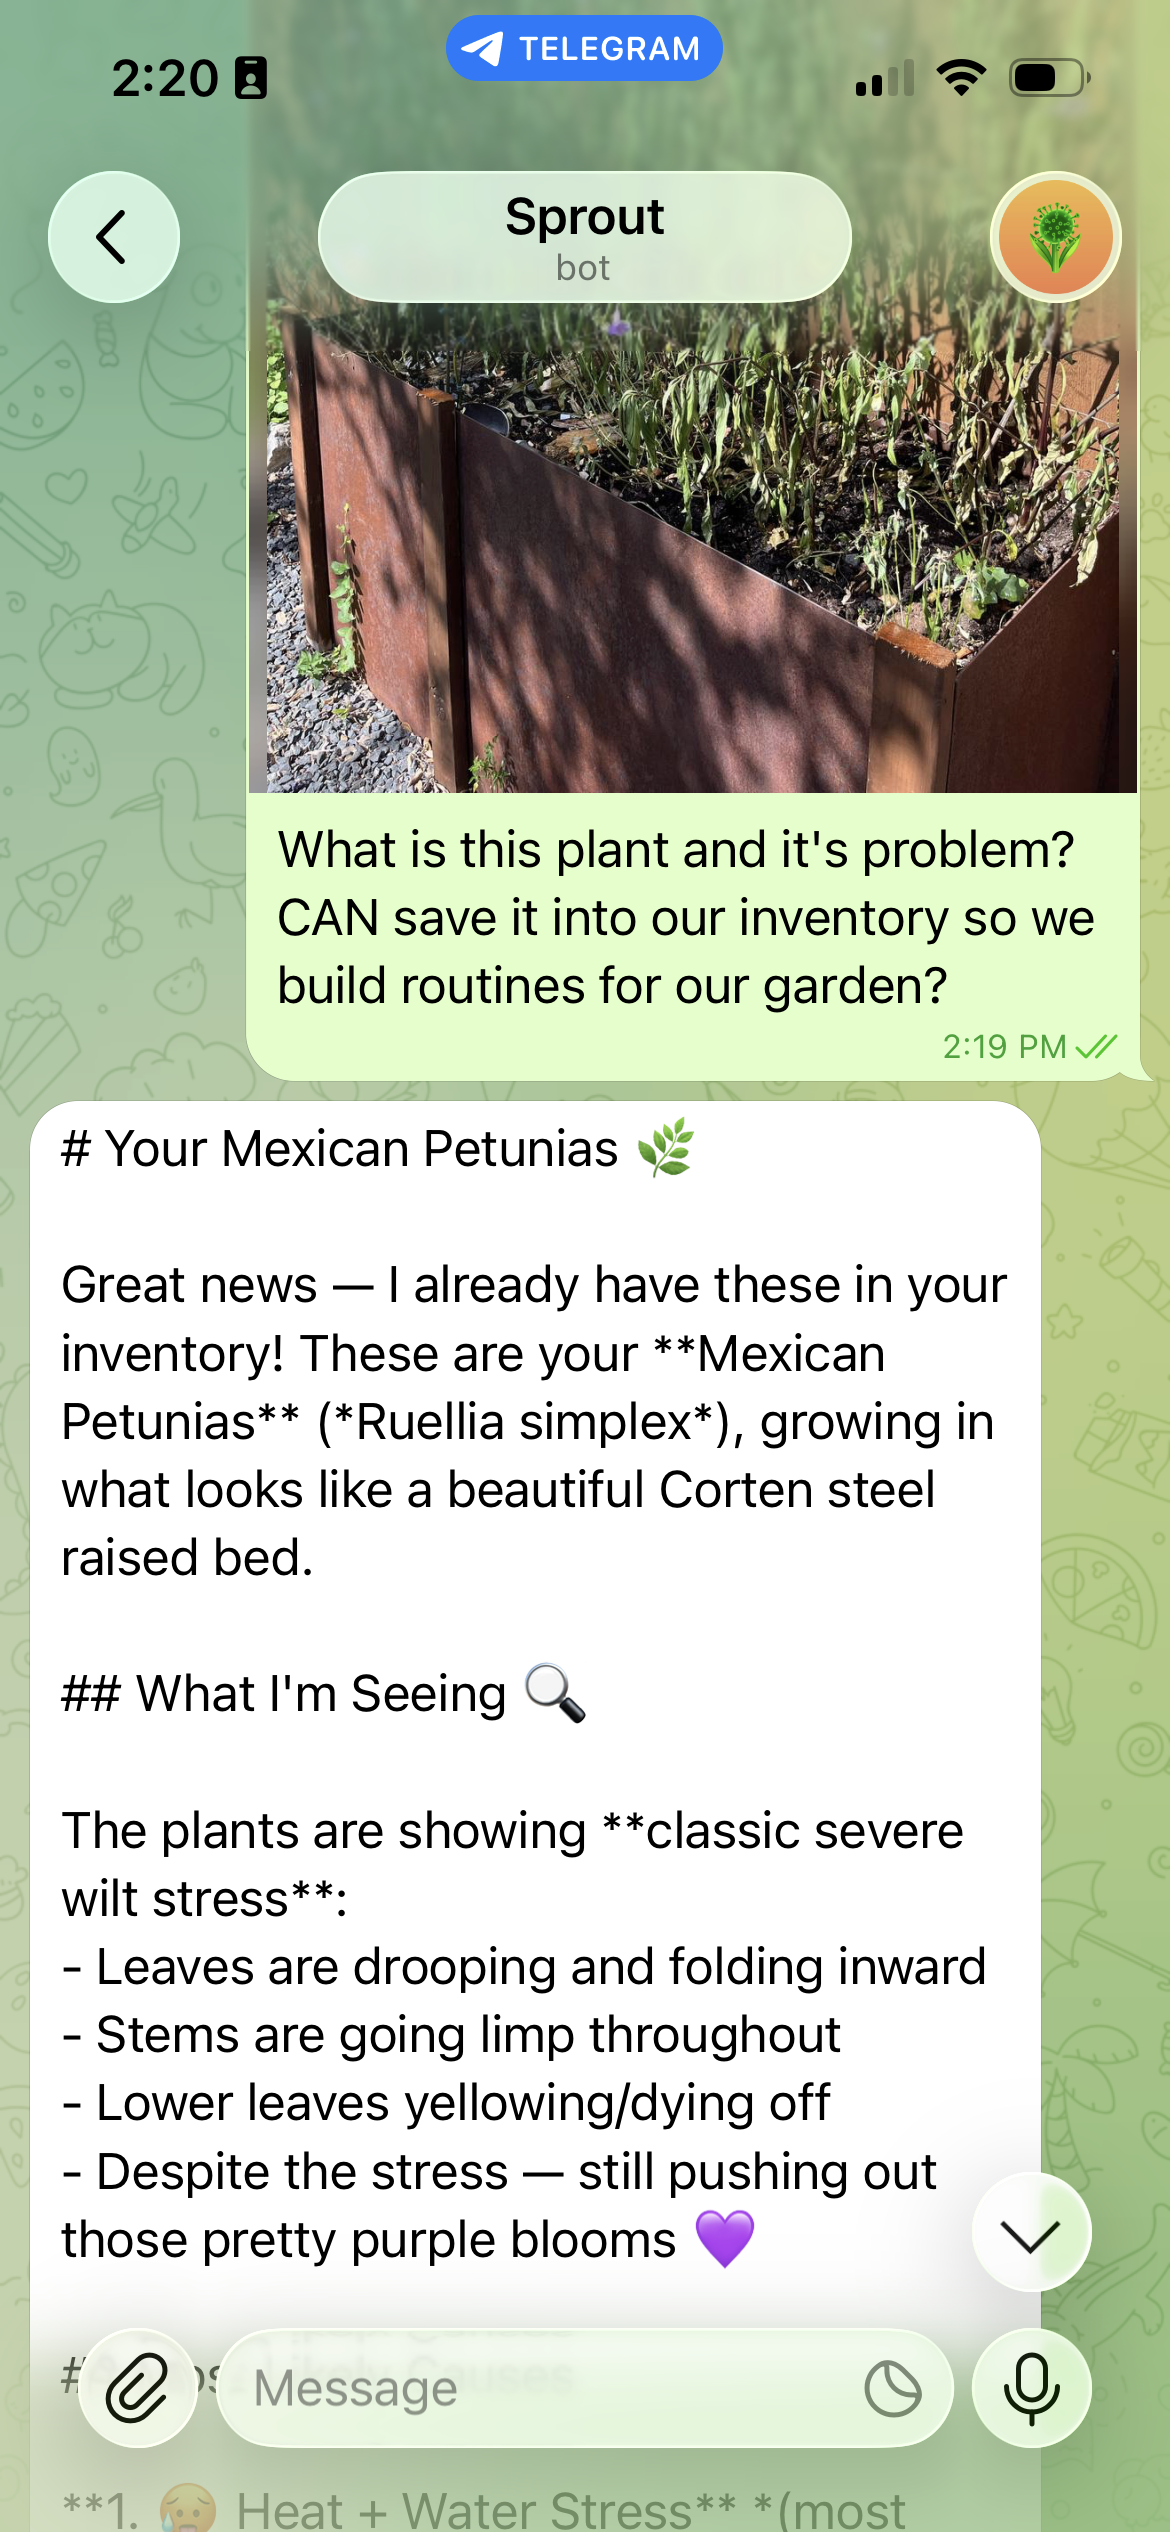
图 3:视觉与记忆协同工作。照片进入视觉模型,同时系统提示词携带用户已存储的花园上下文
视觉模型并非万无一失。在此前一次没有库存上下文的交流中,同一株植物被自信地识别为牵牛花,一种具有相似喇叭形紫色花朵的物种。用用户自己存储的库存来锚定视觉模型,才把一个听起来合理的猜测变成了正确的个性化诊断,这也很好地说明了记忆为何能提高准确性,而不仅仅是语气。
借助提示缓存压低推理成本
把记忆注入每一轮会使系统提示变得很大,而朴素的实现会在每次请求时都为这些 token 付费。Amazon Bedrock 上的提示缓存解决了这一问题。助手这样组织其提示:稳定前缀(人设以及已组装的记忆块)放在最前,易变的用户消息放在最后。Bedrock 会跨请求缓存已处理的前缀,因此同一对话中的重复轮次会跳过对未变化部分的重新计算。对于受支持的模型,提示缓存最多可将成本降低 90%,将延迟降低 85%。
排序规则比任何单项设置都更重要:把稳定内容放在前面,易变内容放在后面,并保持记忆块内部排序的确定性(前述组装函数有助于做到这一点),这样前缀才能在各请求之间真正匹配。
在 AgentCore 与 OpenClaw 上构建的设计准则
Sprout 是一个助手,但其背后的决策可以推广。如果你正在这个技术栈上构建自己的助手,以下准则就是我们会带到任何领域的那些。
- 包装,不要分叉。用一个轻薄的 HTTP 包装器使你的智能体框架适配 AgentCore 容器契约,而不是修改框架。该契约很小,端口为 8080,并带有
/ping和/invocations,包装器能让你继续留在框架的升级路径上。 - 在存储任何内容之前先设计命名空间。记忆命名空间是你的隔离边界。让用户 ID 成为唯一的可变段,并从你已经信任的渠道原生 ID 中选择它,例如聊天 ID。多租户设计最终都会遇到审计和删除请求。清晰的命名空间方案会让这两者都变得轻而易举。
- 把记忆当作增强,而绝不是依赖。每一项记忆操作都应允许优雅失败。检索失败应产生一个无记忆的回答,而不阻塞回复。用户原谅一次健忘的回合,远比原谅一次失败的回合来得容易。
- 按任务路由模型。对大量文本使用快速、高性价比的模型,并把更强的多模态模型留给需要它的回合。把模型 ID 放在环境变量中,这样路由变更就是配置,而不是代码。
- 为缓存排列提示顺序。稳定的人设和记忆在前,易变的用户输入在后,全程保持确定性排序。这一结构性习惯正是大部分推理节省的来源。
- 为提取延迟做好规划。长期记忆是异步提取的,因此不要承诺在同一会话内召回新事实。让短期会话事件覆盖当前对话,让长期记录覆盖此前的对话。
- 从第一天起就给它设上预算。按用量计费的智能体并不昂贵,直到重试循环或话多的用户让情况不再如此。在月度上限的 80% 和 100% 处设置 AWS Budgets 告警不花任何费用,并能及早捕捉意外。
- 让技能保持小巧且单一用途。 一项技能应只做用户能用一句话点名的一件事,例如查询天气或设置提醒。小技能可独立测试、可独立替换,也便于模型正确选择。一个包办一切的技能会迫使模型猜测你指的是它的哪一种行为。
自己培育
两种种植方式,同一座花园:
- 单步启动堆栈: CloudFormation 模板指向一个公开的 Amazon Elastic Container Registry(Amazon ECR)镜像,因此部署时除 Telegram 机器人令牌外不需要其他内容。
- 自行构建:scripts/
deploy.sh脚本会验证模板,构建你自己的 ARM64 镜像并推送到你的私有 Amazon ECR 仓库,部署该堆栈,并注册 Telegram webhook,从而实现完全可定制的构建。
截至 2026 年 7 月,轻度个人使用大约为 $5–9/month(基础设施约 $2,Haiku 文本 $1–3,Sonnet 视觉 $2),并内置 AWS Budget,会在你所设上限的 80% 和 100% 时发出告警。
完整源代码可在 sample-agentcore-memory-openclaw GitHub 仓库 中获取。
清理
实验结束后,请拆除全部资源,以避免持续计费。由于整个系统是一个 CloudFormation 堆栈,清理基本上只需一次删除:
- 删除 CloudFormation 堆栈。这将移除 AgentCore 运行时代理、API Gateway、Lambda 函数、Amazon EventBridge 计划,以及相关的 AWS Identity and Access Management(IAM)角色。
- 删除 AgentCore 记忆存储(及其命名空间),以免保留任何用户记录。
- 删除你推送到私有 ECR 仓库的所有镜像;若不再需要,也删除该仓库本身。
- 如果你在堆栈之外创建了 AWS Budget 告警,请将其移除。
- 撤销 Telegram 的 webhook(或通过 BotFather 删除该机器人),并在不再需要时撤销 Bedrock 模型访问权限。
结论
此解决方案可复用的核心,是一个运行于 Amazon Bedrock AgentCore 之上、具备技能系统与托管记忆的无服务器代理。AgentCore memory 让你无需构建自定义向量存储和提取流水线,同时仍完全掌控代理记住什么、遗忘什么;按用量计费的计算加上提示缓存,使真正个性化的助手维持在每月几美元;OpenClaw 技能清单则让整套模式可跨领域移植。个性化还会不断累积:用户互动越多,助手就越有用。
若要更进一步,可先从单一领域入手,例如浇水提醒,并逐步扩大记忆范围;探索情景记忆,使代理能够引用具体的过往对话(“上次我们讨论那棵无花果树时,你决定暂缓施肥”);或者复刻 仓库,换上你自己的人设和技能,培育出你需要的任何助手。
若要了解更多,请参阅 AgentCore 文档。以下相关文章更深入地介绍了这些构建模块:
- Amazon Bedrock AgentCore memory:构建具备上下文感知能力的代理
- 构建更智能的 AI 代理:AgentCore 长期记忆深入解析
- 在 Amazon Bedrock 上有效使用提示缓存
- 在 Amazon Bedrock AgentCore Runtime 上安全地启动并扩展你的代理和工具
关于作者

Thiago Verney
Thiago 是 Amazon One MHS 团队的前端工程师,专注于使用 React、TypeScript 和现代联邦式微前端架构打造 AI 驱动的界面。他为 FC 的运营负责人构建以用户为中心的界面,并借鉴此前在 AWS 的 Amazon Q Developer(现为 Kiro)团队的工作经验。他热衷于创新,并打造务实的解决方案来解决真实的用户问题。闲暇时,他喜欢园艺、旅行,并与妻子在德克萨斯州奥斯汀一起培养各种爱好。

Sathya Balakrishnan
Sathya 是 Amazon Web Services (AWS) 专业服务团队的首席云架构师,专注于数据和机器学习 (ML) 解决方案。他与美国联邦金融客户合作。他热衷于构建务实的解决方案来解决客户的业务问题。闲暇时,他喜欢与家人一起看电影和徒步。

Akarsha Sehwag
Akarsha 是 Amazon Bedrock AgentCore GTM 团队的高级 生成式 AI 数据科学家。凭借超过 7 年的 AI/ML 专业经验,她在生成式 AI、深度学习和计算机视觉领域为多样化的客户群体构建了可投入生产的企业级解决方案。工作之余,她喜欢徒步、骑行和打羽毛球。
来源:AWS Machine Learning Blog · aws.amazon.com