如何在 Amazon Bedrock 上用 Grok 4.7 构建长程智能体
Build long-horizon agents with Grok 4.7 on Amazon Bedrock
这篇教程在 Amazon Bedrock 上用 Grok 4.7 搭建工具调用智能体,并用故障诊断、维护排期和迁移预算三个任务比较推理强度。72 次运行答对 67 次,其中 xhigh 档 18 次全部正确,low 档答对 15/18,输出 token 约为 xhigh 的八分之一。
SpaceXAI 的 Grok 4.7 现已在 Amazon Bedrock 上提供,后者提供来自多家提供商的基础模型(FM)供选择。据 SpaceXAI 称,Grok 4.7 经过训练,能够在更困难的任务上工作更长时间,并且知道何时检查自己的工作。这对智能体最为重要,因为智能体要历经多个步骤推进一项任务,并且必须沿途核验其所发现的内容。
以这种方式工作的智能体所要做的不只是查找信息。它必须形成一个候选答案,对照已学内容进行核验,并不断改进直至吻合。Grok 4.7 提供 reasoning effort 设置,用于控制每次响应之前进行多少斟酌;对于智能体工作负载,一个实际问题是应该运行哪个级别。
在本文中,我们在 Grok 4.7 上构建了一个工具调用智能体,并在三项需要搜索而非查找的任务上对其进行评估。这些任务分别是:根据告警诊断双服务中断、在相互作用的约束下安排维护,以及在预算内选择一组最优迁移。每项任务恰好有一个正确答案,并通过暴力穷举加以验证。我们在每个 reasoning effort 级别上将这三项任务各运行六次,共计 72 次智能体运行。
该智能体在 72 次运行中正确回答了 67 次。在 xhigh 时,18 次全部回答正确;在 low 时,18 次中回答正确 15 次,同时输出 token 用量约为八分之一。由此得到一个可以按请求调节的明确权衡,我们将展示如何在你自己的任务上测量它,以及如何在生产环境中监控它。
我们通篇报告 token 数量,而非货币金额。Token 价格会变化,而数量才是推导你自身成本的依据,因此以 token 表示的测量结果仍然有效。
SpaceXAI 关于 Grok 4.7 的报告
据 SpaceXAI 称,Grok 4.7 使用比 Grok 4.6 更大的基础模型,并在更难的任务组合上经过了更长时间的强化学习训练。该组合偏向于需要许多小时才能完成的问题。SpaceXAI 报告称,该模型更擅长核验自己的工作,也更擅长管理更长的上下文。
SpaceXAI 公布的基准测试结果体现了这一侧重点。相对于 Grok 4.6,所报告的最大增益出现在衡量持续工作而非单轮回答的类别中。
| 基准测试 | 类别 | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | 多小时终端工作 | 20.3% | 37.6% |
| EEBench | 电气工程 | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | 法律工作 | 15.8% | 19.6% |
| CursorBench 4.0 | 更长时间的编程工作 | 40.4% | 46.3% |
| HealthBench Professional | 临床推理 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 多小时办公工作 | 1,546 | 1,657 |
来源:SpaceXAI,Introducing Grok 4.7(https://x.ai/news/grok-4-7)。分数为模型发布时 SpaceXAI 所公布的分数。
基准测试展示模型在标准任务上的表现。对于你自己的工作负载,有用的下一步是在形态与你的任务相似的任务上进行测量,而这正是本文其余部分所逐步讲解的内容。
SpaceXAI 为 Grok 4.7 列出 500K token 的上下文窗口,支持文本与图像输入以及文本输出。在 Amazon Bedrock 上,该模型支持可配置的 reasoning effort、工具调用和结构化输出。
如何在 Amazon Bedrock 上访问 Grok 4.7
Grok 4.7 运行于 bedrock-runtime 端点,并通过 跨区域推理 配置文件进行访问。共有两种配置文件可用:
| 推理配置文件 | 路由 | 何时使用 |
| us.xai.grok-4.7 | 美国地理区域内 | 您有美国数据驻留要求 |
| global.xai.grok-4.7 | 商用 AWS 区域 | 您没有驻留限制,并希望获得最大容量 |
跨区域推理会在多个 AWS 区域之间路由请求,从而让您获得更高吞吐量,而无需逐区域管理容量。请求指定的是某个推理配置文件,而不是裸模型 ID。
该模型支持与 OpenAI 兼容的 Chat Completions 和 Responses API,以及 Amazon Bedrock Converse API。在 Converse 上,推理内容会作为 reasoningContent 块与 text 块一并返回。在 inferenceConfig 中只设置 maxTokens,并将模型特定参数(例如推理力度)放在 additionalModelRequestFields 中。
有关当前支持的区域、服务层级和令牌价格列表,请参阅《Amazon Bedrock 用户指南》中的 Grok 4.7 模型卡以及 Amazon Bedrock 定价页面(https://aws.amazon.com/bedrock/pricing/)。
前提条件
- 一个能够访问 Amazon Bedrock 且已为 Grok 4.7 启用模型访问权限的 AWS 账户。
- Python 3.9 或更高版本,并已安装
openai、boto3和aws-bedrock-token-generator。 - 已在您的环境中配置 AWS 凭证。
您的 AWS Identity and Access Management (IAM) 身份需要对推理配置文件和您账户的默认项目都拥有 bedrock:InvokeModel:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7或等效的global.。arn:aws:bedrock:{region}:{account-id}:project/default。
在策略语句中同时包含这两项资源。除推理配置文件之外,还需要默认项目权限。
连接到模型
对于生产用途,我们建议根据您现有的 AWS 凭证生成短期 bearer 令牌,这样身份验证会始终绑定到您的 IAM 身份,且不会存储长期有效的密钥:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
推理令牌计入输出令牌,并且会在生成答案文本之前消耗 max_completion_tokens,因此请将上限设置得留有余量,以同时容纳两者。如果在推理期间达到上限,响应会在没有答案文本的情况下返回,因此请在智能体代码中检查空内容,若出现这种情况则提高上限。我们的运行使用了 32,768 个令牌的上限,这在每个力度级别都留有余量。
Grok 4.7 支持四个力度级别:low、medium、high 和 xhigh。力度级别可能随模型版本而变化,因此最好对照服务加以确认,而不是硬编码一份列表:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
设计需要推理的任务
许多智能体评估测试的是勤勉程度:读取一条记录、对其进行筛选、再将其累加。这些任务值得保留,但要看出推理力度带来的贡献,任务必须要求搜索:答案不能直接从数据中读出,而必须先提出,然后再加以核验。
我们构建了一个由 20 个服务组成的合成环境,通过七个工具对外提供,并在其上设置了三项任务。每项任务都恰好有一个正确答案,并且每项任务的构造方式都使得快速启发式方法不足以找到该答案。
| 任务 | 智能体必须完成的工作 | 使其成为推理任务的原因 |
| two_fault_diagnosis | 两项服务在 03:00 静默失败,另外 12 项服务发出了警报。找出失败的那两项 | 失败的服务不会发出警报,因此答案不在发出警报的服务之中。可能的配对有 190 种,只有一种能恰好解释所观察到的警报 |
| maintenance_schedule | 在四个晚上为八项服务打补丁,每晚两项,并遵守十项约束以及同一团队的两项服务不得安排在同一晚的规则 | 可能的日程有 2,520 种,只有一种有效。团队规则依赖于智能体必须查询的数据 |
| migration_budget | 选择要迁移的候选对象,以便在预算范围内(包括传递性先决条件)最大化风险降低 | 53 个可行集合,仅一个最优。优先选取最佳比率,得到的集合比最优解少 9 分 |
有四项做法能让这类测量保持可信,而且它们适用于大多数智能体评测。
写明评分器所依据的每一条规则。 如果提示词对某个边界情况留有余地,合理的答案也可能被判为错误,评测最终衡量的就会是规范而非模型。例如,诊断提示词明确说明,故障服务本身不会发出告警。
证明每个任务只有一个答案。 每个环境都小到足以枚举,因此我们在运行任何内容之前核对了每一个候选答案。对于排程,只需几行:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
只对规定的最后一行评分,而非整段回复。 每条提示都要求智能体以诸如 FINAL: auth, checkout 的一行结束。评分器只读取该行,因此在解释推理时讨论了其他候选的回复,只按其结论评分:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
将格式与正确性分开追踪。 缺少最后一行与最后一行不正确是不同的信号。在我们的运行中,全部 72 条回复都包含可评分的最后一行。
在已知有效取值的地方用 enum 约束工具参数,使每次工具调用都指向真实资源:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
系统提示刻意写得很短,并要求智能体在给出答案之前先检查自己的答案:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
智能体循环是标准的工具调用循环:在设置 reasoning_effort 的情况下调用模型,执行每一个返回的工具调用,以 tool_call_id 为键追加结果,并重复这一过程,直到模型不再请求工具。在整个循环中追踪 prompt_tokens 和 completion_tokens,即可得到下一节所报告的 token 数量。
结果
每个任务在每个努力级别各运行六次,共计 72 次运行。智能体答对了 67 次。
| 任务 | low | medium | high | xhigh |
| two_fault_diagnosis | 6 次中的 5 次 | 6 次中的 6 次 | 6 次中的 6 次 | 6 次中的 6 次 |
| maintenance_schedule | 6 次中的 5 次 | 6 次中的 5 次 | 6 次中的 5 次 | 6 次中的 6 次 |
| migration_budget | 6 次中的 5 次 | 6 次中的 6 次 | 6 次中的 6 次 | 6 次中的 6 次 |
| 全部三项任务 | 18 次中的 15 次 | 18 次中的 17 次 | 18 次中的 17 次 | 18 次中的 18 次 |
| 每次运行 | low | medium | high | xhigh |
| 平均输出 token | 1,184 | 6,430 | 6,778 | 9,147 |
| 相对于 low 的输出 token | 1.0x | 5.4x | 5.7x | 7.7x |
| 平均工具调用次数 | 17.2 | 18.7 | 17.8 | 18.1 |
| 耗时中位数 | 18s | 98s | 89s | 106s |
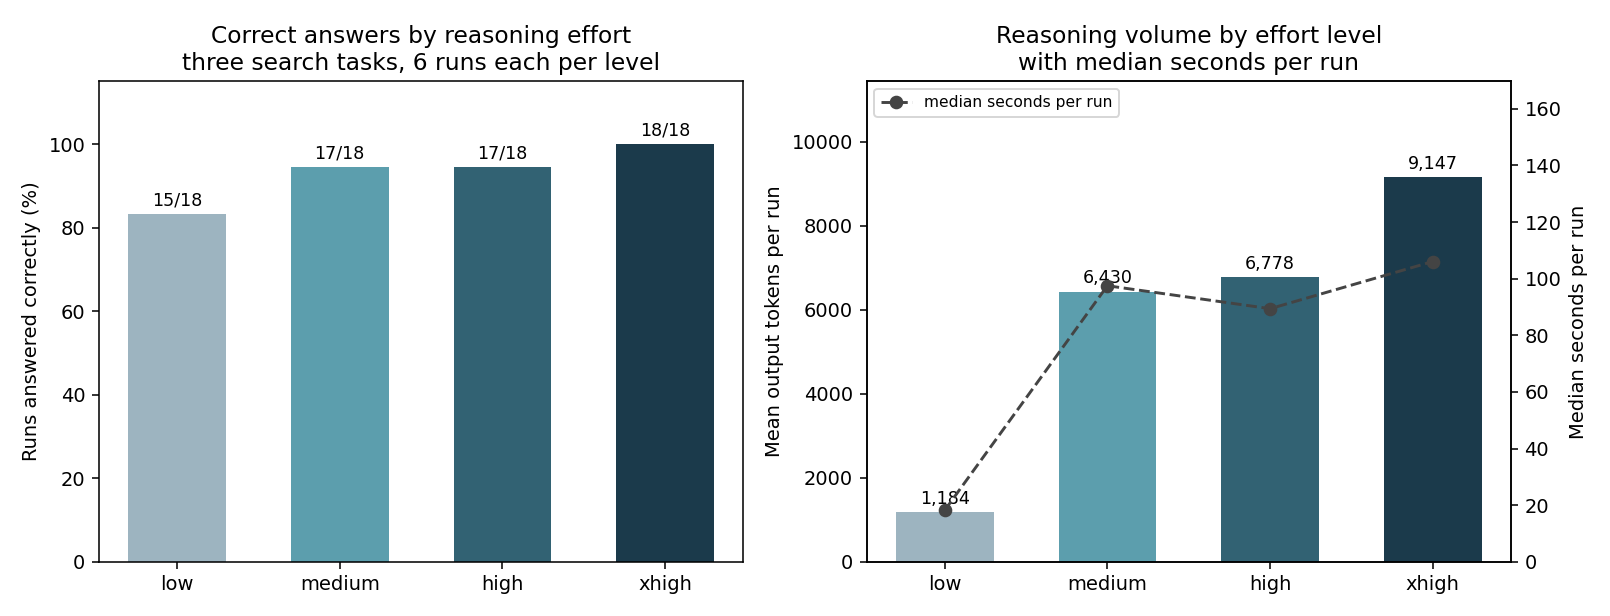
图 1:各推理努力级别下答对运行的占比(左),以及每次运行的平均输出 token,并叠加每次运行耗时的中位数(秒)(右)
三点观察。
xhigh 每次运行都答对了。 三项任务在 xhigh 下的全部 18 次运行均正确,medium 和 high 则各答对 18 次中的 17 次。由于每个任务、每个级别只有六次运行,级别之间的差异只具指示性,而非统计上的定论,而且这一方向在全部三项任务上一致。
努力程度改变的是智能体推理的多少,而非探索的多少。 工具调用基本持平,每个级别每次运行都在 17.2 到 18.7 次之间。无论努力程度如何,智能体收集到的事实都相同;变化的是它对这些事实施加了多少推理,输出 token 从 low 时的 1,184 上升到 xhigh 时的 9,147。
low 具有出色的成本质量比。 在 low 下,该智能体在 18 次运行中答对了 15 次,所用输出 token 约为 xhigh 的八分之一,单次运行的中位时间为 18 秒。若可接受略低的完成率,或答案会在下游被复核,low 是高效的选择。若每个答案都必须一次就对,更高等级是更稳妥的默认选项。
努力等级如何塑造答案
这些任务围绕一种特定的难度而设计,观察每个努力等级如何应对它们,就能说明额外推理在何时值得付出。
优化。 迁移任务奖励的是综合考虑各种组合,而不是逐一给选项排序。选出单项比率最佳的候选,会得到一个合理但比最优解低九分的答案。在 medium 及以上,智能体在全部 18 次运行中都找到了最优集合。
假设检验。 诊断任务要求从两个方向检查候选配对:每一条告警都必须得到解释,每一个保持沉默的服务也必须与答案一致。在 medium 及以上,智能体在全部 18 次运行中都识别出了正确配对。
约束满足。 调度任务把十条列出的约束与一条依赖于查询所得归属数据的团队规则结合起来。xhigh 在每次运行中都生成了有效日程,而这是最高等级差异最为明显的任务。
这三项呈现出的规律是:当智能体必须在多个候选答案之间相互权衡,而不是沿单一路径得出结果时,额外的推理努力最有价值。
在生产环境中监控推理
在生产环境中,你并没有已知答案可供对照评分,但你确实知道每次运行使用了多少输出 token 和工具调用。这些能提供有用的运维信号。
每个级别的正确运行都维持在明确的推理量下限之上。medium 及以上的每一次正确运行至少使用了 1,739 个输出 token,典型运行则使用了数千个。一次运行若未进行任何工具调用,或产生的输出远少于其所在级别的正常水平,就值得标记以供审查:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
根据你已评分的运行,按任务和努力级别校准基线,再将其应用于尚未评分的运行。把标记当作检查或重新运行的提示。在 low,每次运行都很简短,输出量是较弱的信号,因此应配合抽查。
在系统提示中要求智能体核对其答案值得保留,因为这能让你在审查一次运行时直接跟上智能体的推理。凡是存在已知答案之处,都将其与自动评分配合使用,从而使质量衡量独立于记录文本。
选择推理努力
这些结果提示了几条实用规则。
让努力与任务类型相匹配。涉及搜索、优化或检验假设的任务,从 medium 或更高水平获益最大。遵循单一路径的任务,或答案会在下游接受审查的任务,可以在 low 高效运行。
按请求而非按智能体设置努力。努力是请求参数,因此智能体可以在更高水平上执行规划与验证步骤,而在 low 执行机械步骤,例如格式化工具结果。这样既能保留较高水平的大部分可靠性,又能降低 token 成本。
在你自己的任务上测量,并重复运行。每种配置只运行一次只能得到一次观测。将每种配置重复运行若干次,可以看出它的一致性如何。
监控推理量。按努力级别跟踪每次运行的输出 token 和工具调用次数,能在结果被采用之前,提前给出复查该次运行的信号。
此项测量的局限性
每个任务、每个努力级别运行六次。足以在三个任务上显示一致的方向,但不足以得出置信区间。请将各级别之间的差异视为指示性的。
合成环境。这些工具读取代码生成的数据,正因如此才能证明每个任务恰好有一个答案并自动评分。真实工具会增加延迟、部分结果和错误,这些都未在此测试。
是分钟,不是小时。运行时间中位数从 low 的 18 秒到 xhigh 的 106 秒不等。这是对长时程工作的缩小版代理。方法可以迁移。绝对数字则不能。
一个模型版本、一个 Region、每个任务一个提示。同一任务的不同表述可能会改变结果,这也是为何必须明确陈述每一条规则的部分原因。
是 token 计数,不是成本。要换算成货币,请套用 Amazon Bedrock 定价页面上适用于你的推理配置文件和服务层级的当前费率。Global 与 US Geo 配置文件的定价不同,Flex 和 Priority 服务层级会应用乘数。
智能体工作负载的运维控制
内置重试。发出大量调用的智能体应将重试作为设计的一部分。设置请求超时,只重试可重试的错误,采用带抖动的指数退避,并在返回 Retry-After 标头时予以遵守:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
按需吞吐量会随时间提升,因此应逐步加大新的高流量工作负载,而不是一开始就以满速率运行。
审计一次运行。模型调用日志会将请求和响应数据写入 Amazon Simple Storage Service (Amazon S3) 或 Amazon CloudWatch Logs。这样你就能获得事后想要复查的运行的完整记录。
大规模监控推理量。Amazon CloudWatch 指标为你提供 token 用量的汇总视图,前文所述的各级别基线正是在这里变成可以设置告警的对象。
在各智能体之间归因支出。AWS Cost Explorer 和 AWS Cost and Usage Report 中的成本明细按模型拆分用量,再结合每个任务的 token 计数,既能得到单位经济性,也能得到总账单。
让成本与紧急程度相匹配。服务层级按请求设置,因此同一部署可以把隔夜分析走 Flex 层级,把交互式请求走 Priority。对于以更高努力级别运行的工作负载,层级选择是成本上的又一个杠杆。
选择路由配置文件。跨区域推理扩大了长时间运行所取用的容量池。Global 配置文件从你选择的商业 AWS 区域提供服务,通常每个 token 的价格低于地理路由。US 配置文件将处理保持在美国境内。请根据数据驻留要求以及成本来选择。
清理
本文中的示例除按请求计费的 token 用量外,不会创建可计费的 AWS 资源。如果你生成了长期 Amazon Bedrock API 密钥,请在完成后于 Amazon Bedrock 控制台中将其删除,因为它在被撤销之前一直有效。由 IAM 凭证生成的短期 token 会自行过期。
如果你在测试期间启用了将模型调用日志记录到 Amazon S3 的功能,请检查该存储桶并移除不再需要的对象。
结论
SpaceXAI 训练 Grok 4.7,使其能在更困难的任务上工作更长时间,并知道何时检查自己的工作。在三项需要搜索而非查找的任务中,该智能体在 72 次运行中有 67 次回答正确,且每一次运行都在 xhigh。由于推理力度是按请求设置的,你可以选择智能体的每一步落在彻底性与 token 成本这一权衡的哪个位置。
有三件事值得带入你自己的评估。设计具有一个可证明答案的任务,并写明评分器所依赖的每一条规则。重复运行,以便看出每种配置的一致性。同时按力度级别监控输出 token 和工具调用,这样除质量测量之外,你还能获得一项运维信号。
延伸阅读
- 在 Amazon Bedrock 上推出 Grok
- Grok 4.7 现已在 Amazon Bedrock 上提供
- 使用跨区域推理在各个 AWS 区域之间路由模型推理请求
- Amazon Bedrock 入门
- Chat Completions API
- Amazon Bedrock 定价
- 推出 Grok 4.7 (SpaceXAI)
关于作者

Suheel Farooq
Suheel 是 AWS 的首席解决方案架构师,专注于人工智能、机器学习和生成式 AI。他帮助基础模型提供商客户在 AWS 上设计、构建、现代化并扩展其 AI/ML 和生成式 AI 工作负载——从将基础模型引入 Amazon Bedrock,到优化训练与推理以及构建智能体 AI 解决方案。他的经验涵盖 AWS AI/ML 和生成式 AI 产品组合,尤其是 Amazon Bedrock、Amazon Bedrock AgentCore 和 Amazon SageMaker AI。闲暇时,Suheel 喜欢健身和徒步。

Anirban Gupta
Anirban 是 AWS 的首席工程师,常驻美国西雅图,专注于为 Amazon Bedrock 设计安全、大规模的模型服务基础设施。他推动了该平台上多次基础模型发布背后的技术工作。在加入 Amazon Bedrock 之前,他是 AWS Outposts 的首席工程师,负责构建混合本地云基础设施。

James Wang
James 是 SpaceXAI 的高级产品增长经理。此前,他曾任 Cerebras 产品营销总监,在那里推出了 Cerebras Inference 和 CS-3 AI 加速器。在那之前,James 是 ARK Invest 的首席 AI 分析师。他的职业生涯始于 NVIDIA,在深度学习早期推出了首批支持 CUDA 的 GPU。

Ikenna Izugbokwe
Ikenna 是 AWS 的首席解决方案架构师,专注于网络、容器和 AI 基础设施。他指导模型提供商扩展其训练和推理系统,同时助力不断演进的前沿模型在 AWS 上快速部署。他的工作越来越多地涵盖智能体 AI——构建可靠、具有成本效益的多智能体系统,以及支撑这些系统在生产环境中运行的推理基础设施。
来源:AWS Machine Learning Blog · aws.amazon.com